Histoire de l’intelligence artificielle : des règles de Turing aux réponses de ChatGPT
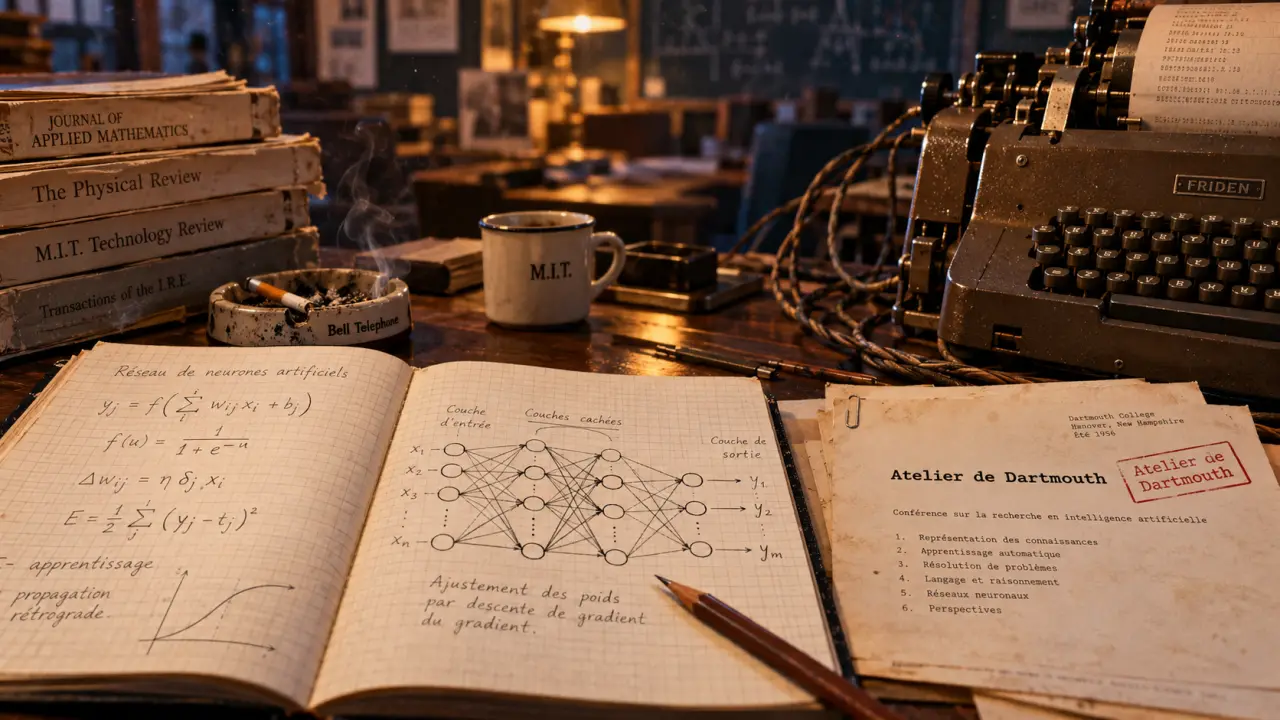
L’intelligence artificielle devient un domaine de recherche identifié en 1956, lors de l’atelier de Dartmouth, aux États-Unis. Mais son histoire commence avant cette date : elle associe les fondements de l’informatique, la logique mathématique et une question persistante : quelles capacités humaines une machine peut-elle reproduire ? Des premiers programmes de raisonnement aux modèles génératifs, ses progrès suivent une trajectoire faite de percées, de déceptions et de changements de méthode.
1950-1957 : définir une machine intelligente et lui donner un nom
L’intelligence artificielle désigne un ensemble de méthodes permettant à des systèmes informatiques d’accomplir des tâches associées à l’intelligence humaine : reconnaître une image, traiter le langage, résoudre un problème ou planifier une action. Cette définition ne suppose ni conscience ni reproduction intégrale du cerveau.
Alan Turing déplace la question vers un test observable
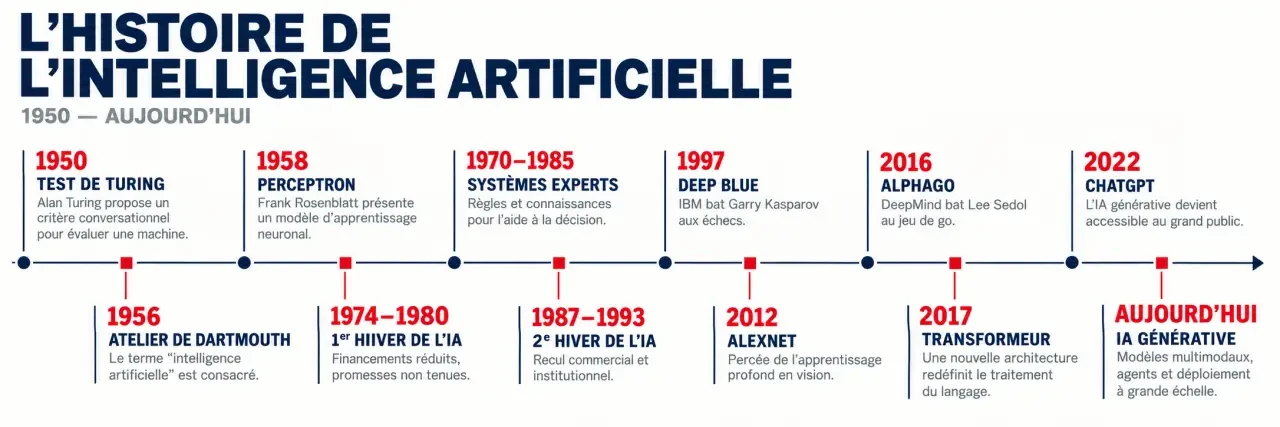
En 1950, Alan Turing publie Computing Machinery and Intelligence. Plutôt que de définir abstraitement la pensée, il propose un « jeu d’imitation » : un interlocuteur échange par écrit avec une machine et un humain, sans connaître leur identité. Ce qui deviendra le test de Turing évalue la capacité à produire une conversation difficile à distinguer de celle d’une personne. Il ne constitue pas une preuve de compréhension ou de conscience.
Dartmouth structure une ambition scientifique
John McCarthy introduit le terme « intelligence artificielle » dans la proposition de recherche de Dartmouth, formulée en 1955. L’atelier organisé en 1956, associé notamment à Marvin Minsky, Claude Shannon et Nathaniel Rochester, devient le repère conventionnel de naissance du domaine. Il ne marque toutefois pas l’invention d’une technologie unique.
Deux directions existent déjà. La première cherche à manipuler des symboles et des règles logiques. La seconde s’inspire du fonctionnement des neurones : Minsky et Dean Edmonds construisent le SNARC en 1951, tandis que Frank Rosenblatt développe le perceptron en 1957, un modèle capable d’apprendre une règle de classification simple.
Des années 1960 aux années 1990 : les règles rencontrent leurs limites
Les premiers succès nourrissent une ambition forte : décrire explicitement le raisonnement pour le faire exécuter par ordinateur. Cette approche, dite symbolique, représente des connaissances sous forme de faits, de relations et de règles. Elle fonctionne particulièrement bien lorsque le problème est délimité et les informations structurées.
Les systèmes experts : efficaces dans un cadre étroit
Les systèmes experts se développent surtout dans les années 1970 et 1980. Leur principe consiste à réunir les connaissances de spécialistes dans une base de règles. Un programme peut alors enchaîner des propositions du type « si telle condition est remplie, alors telle conclusion est plausible ».
Cette méthode permet de justifier certaines décisions, mais pose un problème de maintenance : les règles doivent être collectées, vérifiées et actualisées. Dès que les situations deviennent ambiguës ou sortent du périmètre prévu, la fragilité apparaît. Décrire à la main toutes les variations d’un visage ou d’une phrase se révèle particulièrement difficile.
Pourquoi parle-t-on d’« hivers de l’IA » ?
Les promesses dépassent régulièrement les résultats. Les limites du calcul, le manque de données exploitables et les difficultés techniques entraînent des périodes de désillusion et de réduction des financements, notamment dans les années 1970 puis à la fin des années 1980. Ce sont les « hivers de l’IA ». La recherche ne s’arrête pas, mais certaines ambitions perdent leur soutien.
En 1997, Deep Blue d’IBM bat Garry Kasparov aux échecs. Cette victoire illustre la puissance d’un système spécialisé, associant recherche dans les coups possibles et évaluation des positions. Elle ne signifie pas qu’une intelligence générale, capable de s’adapter à toute tâche humaine, a été atteinte.
Des années 2000 à 2016 : apprendre à partir des données change l’échelle
Le changement central consiste à ne plus écrire toutes les règles de décision : on entraîne un modèle sur des exemples. L’apprentissage automatique regroupe plusieurs méthodes de ce type. Le connexionnisme en constitue une famille, fondée sur des réseaux de neurones artificiels dont les paramètres sont ajustés pendant l’entraînement.
Les travaux de Geoffrey Hinton, Yann LeCun et Yoshua Bengio contribuent au développement de l’apprentissage profond, ou deep learning. Celui-ci utilise des réseaux comportant plusieurs couches de traitement. Son essor résulte d’une convergence : davantage de données numériques, des processeurs adaptés au calcul parallèle et des améliorations des méthodes d’entraînement.
| Repère | Événement | Ce qu’il démontre |
|---|---|---|
| 2011 | Watson d’IBM gagne à Jeopardy! | Un système peut combiner traitement du langage, recherche d’information et classement des réponses. |
| 2012 | AlexNet s’impose dans la compétition ImageNet | Les réseaux neuronaux profonds deviennent particulièrement performants pour classer des images. |
| 2016 | AlphaGo bat Lee Sedol au go | Réseaux neuronaux, recherche et apprentissage par renforcement peuvent être combinés pour maîtriser un jeu complexe. |
Ces jalons ne reposent donc pas sur une recette identique. Watson n’est pas un grand modèle de langage contemporain ; AlphaGo, développé par DeepMind, ne se limite pas à reconnaître des configurations. Une victoire spectaculaire doit toujours être rapportée à la tâche évaluée.
Depuis 2017 : du transformeur aux interfaces génératives
En 2017, une équipe de chercheurs de Google présente l’architecture du transformeur. Son mécanisme d’attention permet de pondérer les relations entre les éléments d’une séquence, par exemple les mots d’un texte. Cette architecture facilite l’entraînement à grande échelle et devient centrale dans de nombreux modèles de langage.
ChatGPT rend une évolution technique visible au grand public
Les grands modèles de langage apprennent des régularités à partir de vastes ensembles de textes. Leur entraînement repose notamment sur la prédiction de tokens, des unités de texte. Des étapes supplémentaires peuvent ensuite améliorer leur capacité à suivre des instructions. Lancé par OpenAI en 2022, ChatGPT rend cette technologie accessible sous la forme d’une conversation.
L’IA générative produit des textes, des images, du son ou du code. Les modèles multimodaux peuvent traiter plusieurs de ces modalités. Il ne s’agit pas d’une catégorie totalement séparée du deep learning : « profond » décrit une famille de méthodes, « génératif » une capacité et « multimodal » les types de données traités.
Une conversation avec une IA agit aussi comme un miroir de nos critères de jugement : une réponse fluide, polie et bien structurée nous paraît facilement compétente. Pour éviter ce piège, séparez trois évaluations : la qualité de la formulation, l’exactitude des faits et la validité du raisonnement. L’histoire du test de Turing prend ici une portée pratique : imiter une bonne conversation ne garantit pas de produire une réponse juste.
Une histoire désormais industrielle, politique et sociale
L’IA est devenue centrale parce qu’elle peut s’intégrer à de nombreux outils : recherche documentaire, traduction, programmation, analyse d’images ou assistance scientifique. Son développement dépend néanmoins d’infrastructures coûteuses, de données et de compétences spécialisées. Les universités restent essentielles, tandis que les grandes entreprises technologiques occupent une place majeure dans l’entraînement et la diffusion des modèles.
Cette évolution transforme les questions publiques. Les biais peuvent reproduire des inégalités ; les usages de données soulèvent des problèmes de confidentialité et de droits ; les contenus synthétiques facilitent certaines manipulations. S’y ajoutent la consommation de ressources, les transformations du travail et la concentration du pouvoir technologique.
En France, le rapport Villani de 2018 constitue un repère de la stratégie nationale pour l’IA. Les débats sur la régulation et la souveraineté numérique prolongent désormais les questions scientifiques. Retenir cette histoire, c’est comprendre que les capacités progressent sans abolir les limites : chaque système doit être jugé sur ses usages réels, ses erreurs et les responsabilités humaines qui accompagnent son déploiement.
- Histoire de l’intelligence artificielle : des règles de Turing aux réponses de ChatGPT - 23 octobre 2026
- Business intelligence avec DataView Pro : des données fiables aux décisions concrètes - 22 octobre 2026
- Rapidesk Solutions pour PME : validez les fonctions, le coût et l’accompagnement avant de signer - 21 octobre 2026
Partager cet article
Articles qui pourraient vous intéresser :
 Logiciel PPM : piloter budgets, capacités et objectifs sans perdre la vue d’ensemble
 Power Platform : 4 briques Microsoft pour créer, automatiser et gouverner vos solutions métier
 Automatiser trop tôt crée de nouveaux goulets d’étranglement : optimiser les processus métiers d’abord
 Dataview Quantum peut fiabiliser le pilotage financier, si les données sont maîtrisées